- 언어 모델은 한 번 학습된 뒤 동결되고, 개선하려면 추가 학습이나 프롬프트·하네스·추론 시점의 계산이 필요하다는 기존 상식을 뒤집는 연구가 arXiv에 공개됐습니다.
- 연구진은 'Self-Rewriting' 방식을 제시했습니다. 오픈 27B 모델이 자기 자신의 가중치·채점된 답변·자가 실행 능력을 주어졌을 때, 자기 실패를 스스로 진단하고 해당 가중치를 직접 수정합니다. 그래디언트도, 별도 학습도 없이 진행됩니다.
- 모델이 연습 문제로 편집 결과를 검증하고 통과한 것만 채택하는 방식으로, 본 적 없는 문제에서 6.6점 정확도가 향상됐고 8회 연속 세션에서 정확도가 계속 상승했습니다.
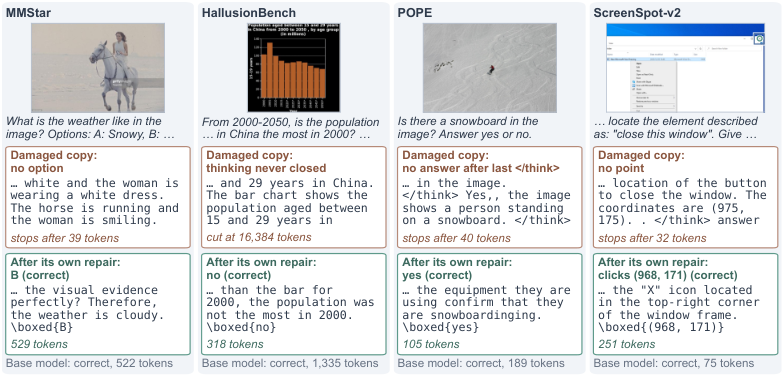
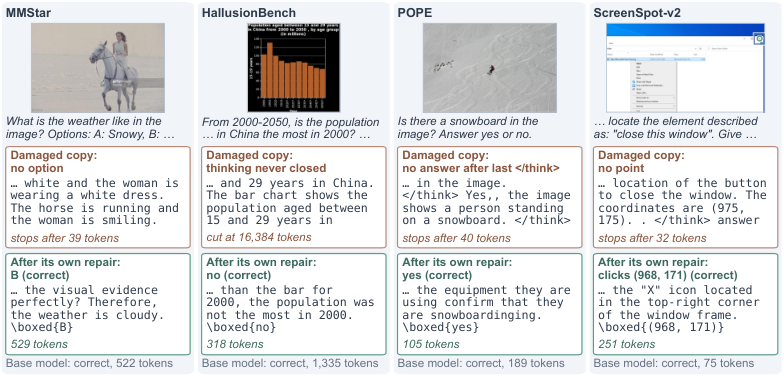
- 손상된 자기 복사본도 재학습 없이 원본 가중치를 읽지 않고 원래 정확도의 80% 이상까지 스스로 복구했습니다.
- 다만 이 능력은 규모에 따라 나타났습니다. 같은 모델 계열에서 작은 모델은 편집에 실패하거나 스스로를 망가뜨렸고, 가장 큰 모델만 자가 개선·복구에 성공했습니다.
- 연구진은 이 방식이 "학습과 추론의 경계는 지능의 속성이 아니라 도구의 한계"라는 관점을 제시하며, 재귀적 자기 개선(recursive self-improvement)을 향한 필수 단계로 봅니다.
--------------------------------------------------------------------------------------광고(Advertising)--------------------------------------------------------------------------------------------------------