**번역본뉴스입니다. 오역이 있을수 있습니다.
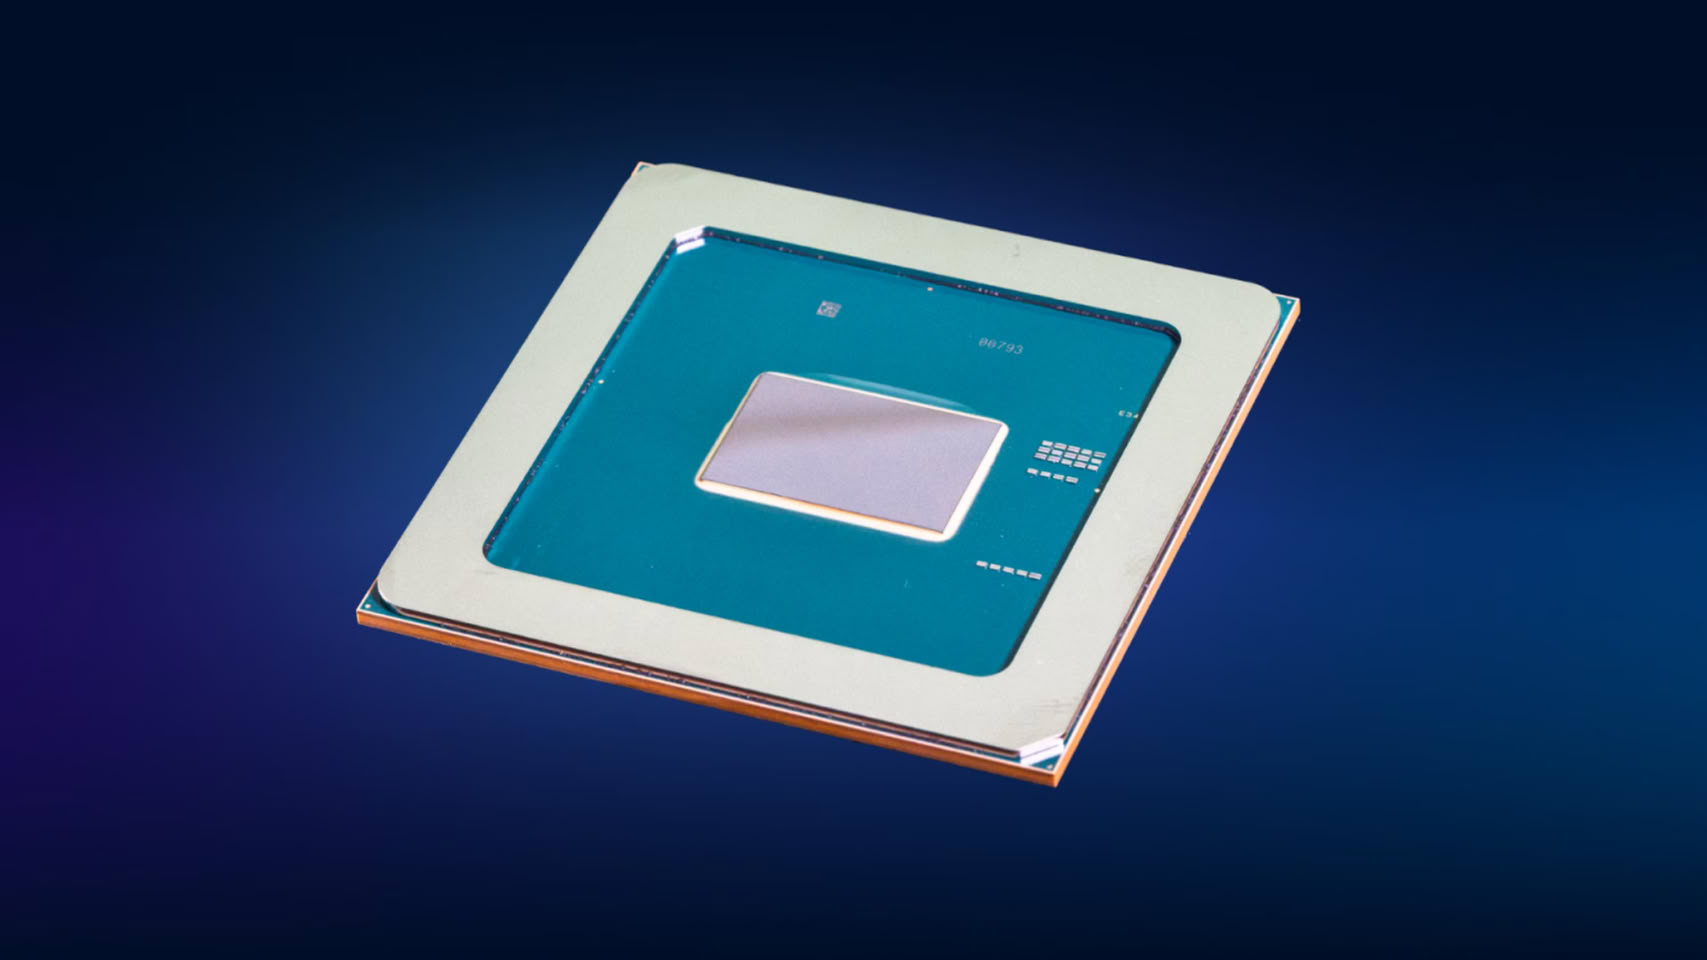
인텔이 최근 Xe3P GPU 마이크로아키텍처 기반의 D-시리즈 "크레센트 아일랜드(Crescent Island)" AI 추론용 그래픽 카드를 발표했으며, 이 중 D270이 최상위 SKU에 해당합니다. 인텔 공식 웹사이트에 GPU 베어 다이(bare die) 샷이 추가되었는데, 예상했던 거대한 칩 형태가 아니라 생각보다 다소 작아 보이는 실리콘 다이의 모습이 드러났습니다.
D270 GPU SKU는 32개의 Xe3P 코어, 256개의 XMX 엔진, 32MB의 통합 L2 캐시를 탑재하고 있습니다. XMX 엔진은 일반 Xe3의 4-딥 시스톨릭(systolic) 구조에서 Xe3P의 16-딥 연산 구조로 재설계되었습니다. 이 카드는 학습(training)보다는 AI 추론(inferencing)을 주 목적으로 설계되었기 때문에 연산 실리콘 면적에 대한 요구 조건이 비교적 덜하며, 최대 480GB 용량의 LPDDR5X 메모리를 지원하도록 규격화되었습니다.
추가 세부 사항으로는 FP8과 함께 FP4 데이터 포맷을 지원하며, 코어당 1MB의 대용량 레지스터 파일과 코어당 512KB의 L1 캐시를 갖추고 있습니다. 총 256개의 벡터 엔진(Vector engine)과 256개의 신형 XMX 엔진이 탑재되었으며, Xe3P 코어당 각각 8개씩 균등하게 배치되었습니다.
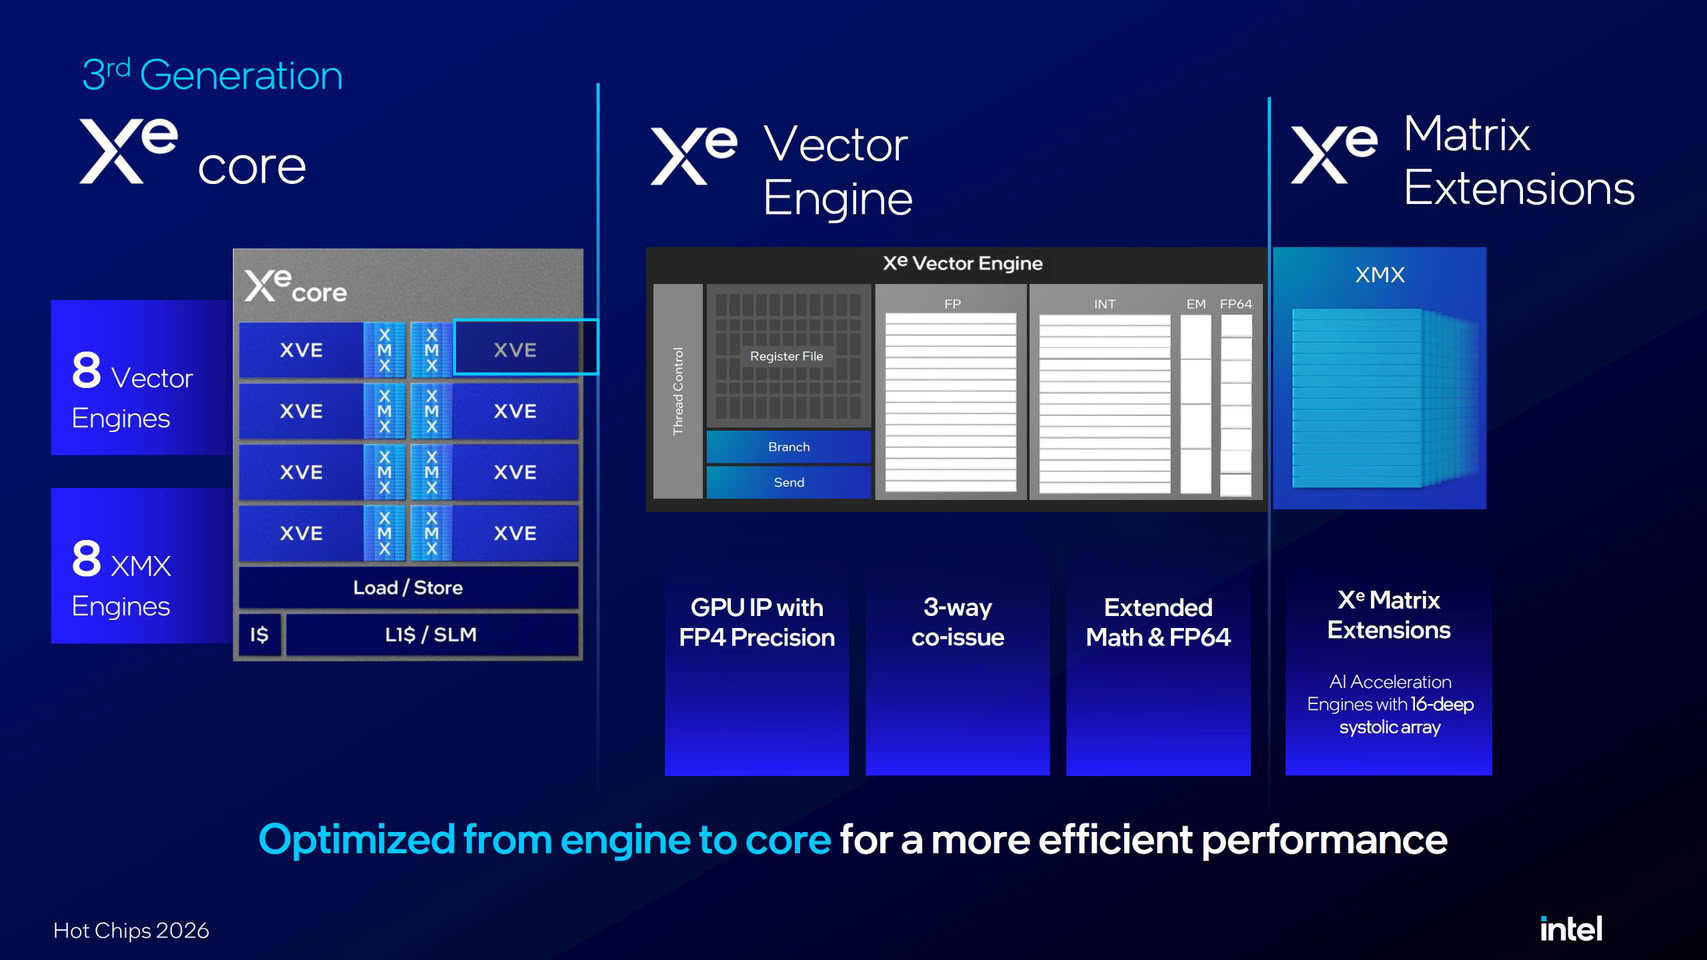
또한 Xe3P는 긴 컨텍스트와 에이전트 워크로드를 요구하는 순수 AI 추론 작업을 위해 설계되었기 때문에 화면을 출력하기 위한 디스플레이 그래픽 렌더링 블록이 제거되었습니다. 비디오 생성 및 이해가 필수적인 멀티모달 파이프라인 처리를 보조할 수 있도록 4개의 인코더와 4개의 디코더로 구성된 미디어 엔진은 그대로 포함되어 있습니다.
이 가속기는 350W 소비 전력의 공랭식 PCIe 5.0 x16 폼팩터로 설계되어, 전용 수랭 설비를 구축할 필요 없이 기존 서버 랙 인프라에 그대로 장착할 수 있습니다. 인텔은 수천 단계의 스텝을 수행하고, 100K 토큰 수준의 컨텍스트를 유지 및 추론하면서도 빠른 토큰 생성 속도를 유지해야 하는 AI 에이전트 환경을 염두에 두고 이 실리콘을 설계했습니다. 향후 실제 벤치마크 성능과 새로운 Xe3P 그래픽스 IP가 AI 연산 처리에서 어떠한 실질적 성능을 보여줄지가 관건입니다.
--------------------------------------------------------------------------------------광고(Advertising)--------------------------------------------------------------------------------------------------------


