**인텔뉴스룸 번역본입니다. 오역이 있을수 있습니다.
HPC 및 AI 워크로드에 필요한 정밀도와 처리량을 인텔 GPU D270에 제공합니다
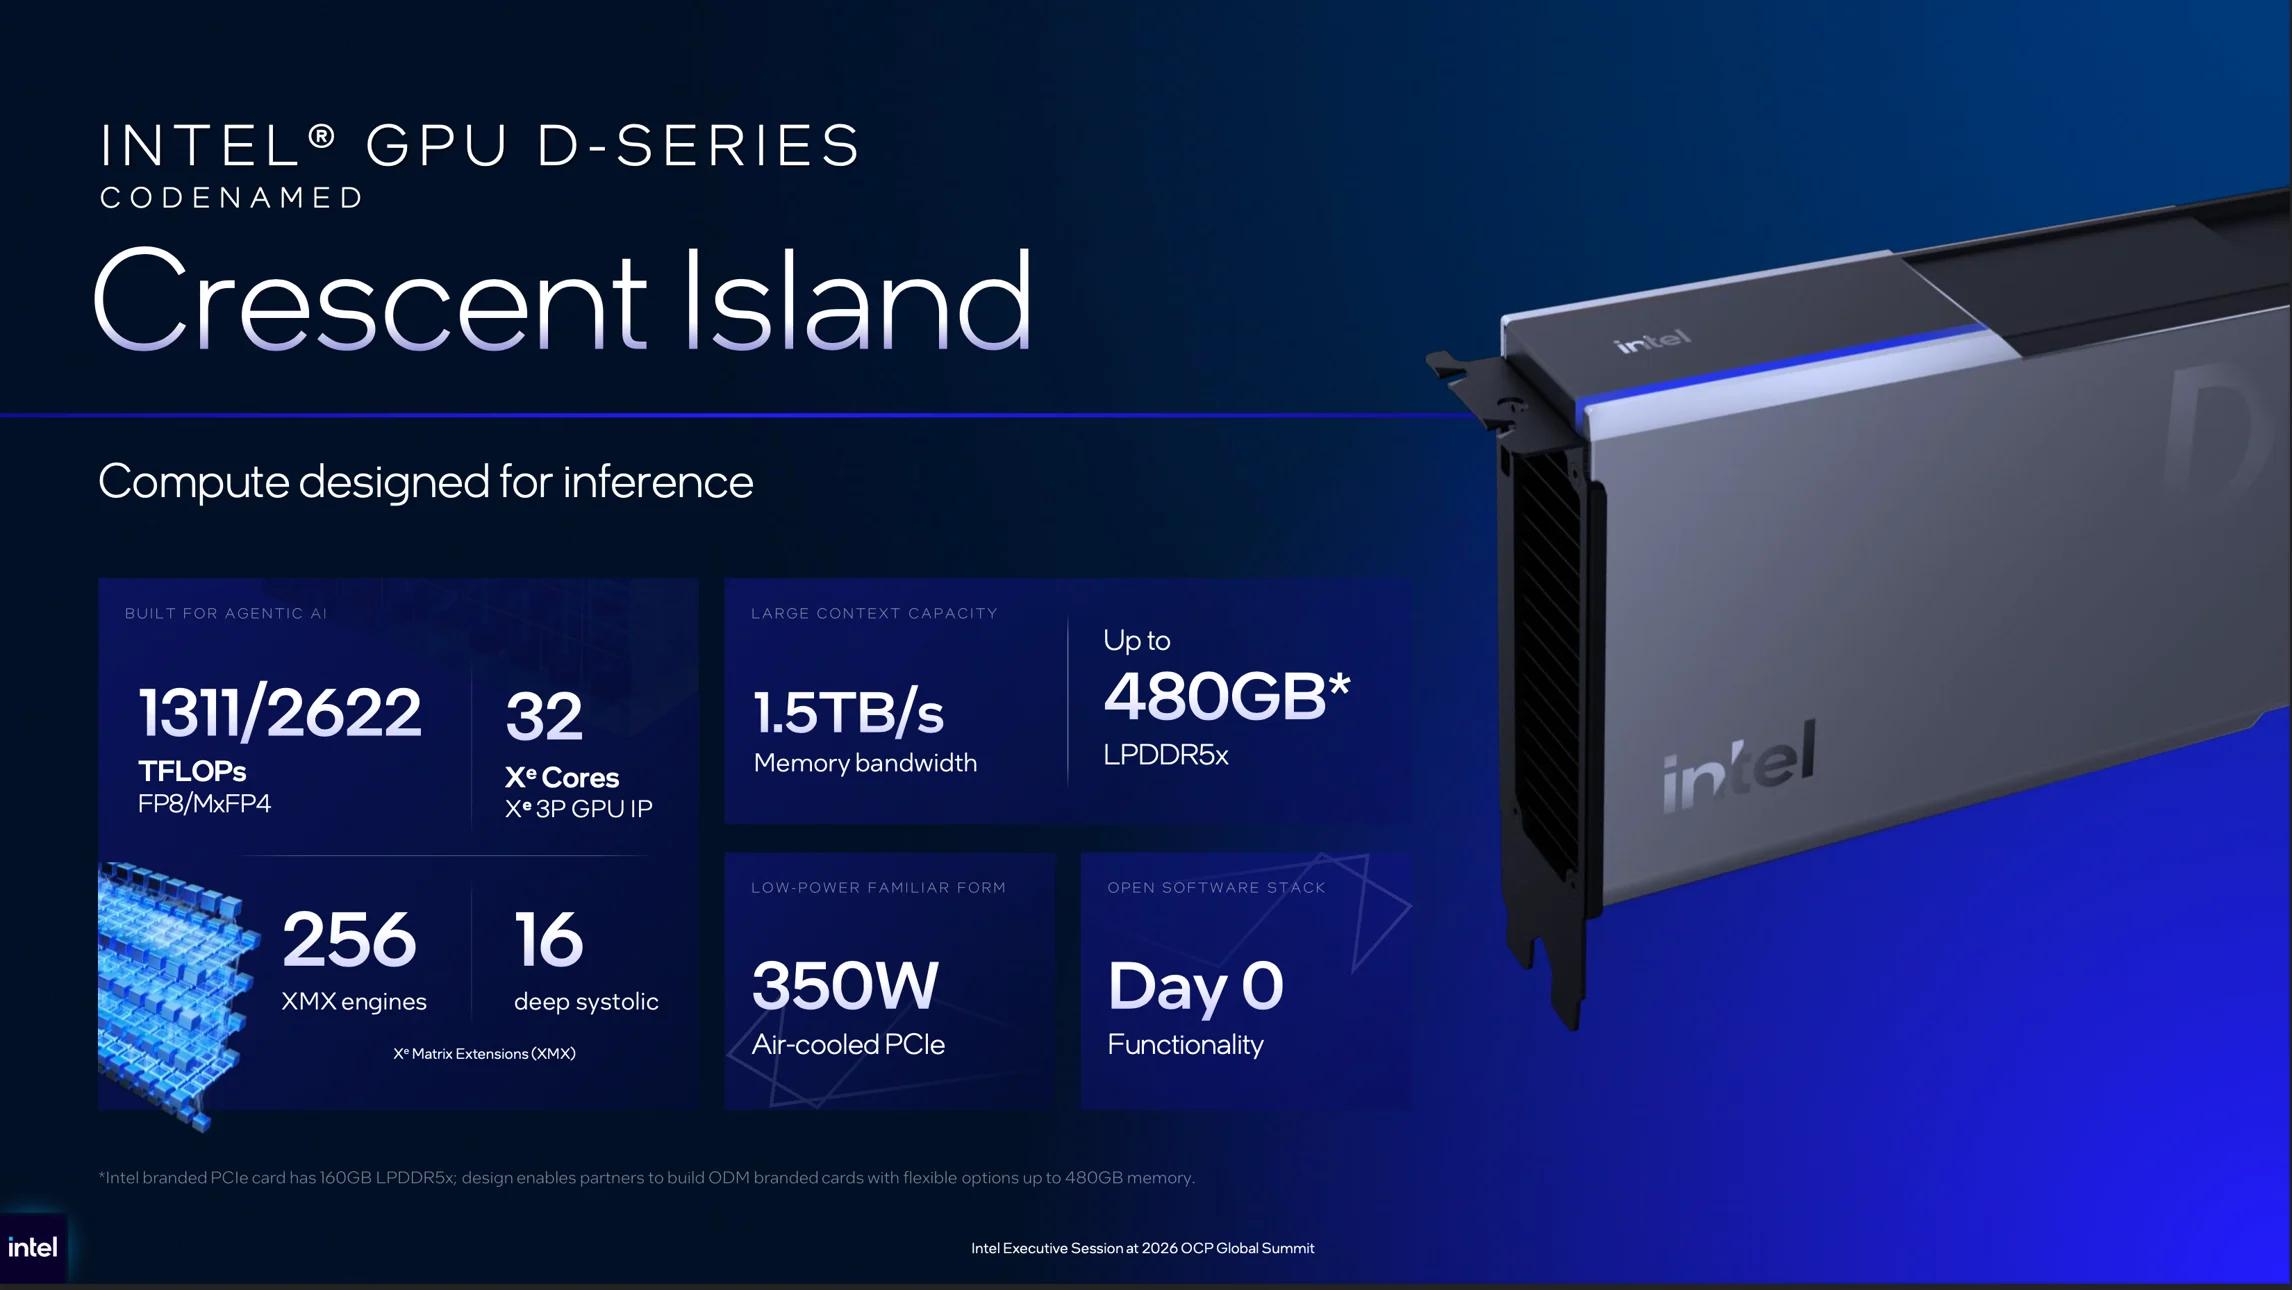
한눈에 보기: 인텔 GPU D270 (Crescent Island)
-
실리콘 및 정밀도: Xe 3P 아키텍처, 32개 Xe 코어, 256개 XMX 엔진; 풀 레이트 배정밀도를 갖춘 네이티브 FP4부터 FP64 지원.
-
메모리 및 플랫폼: 160 GB LPDDR5X (1.5 TB/s 대역폭, 최대 480 GB까지 확장 가능); 350W PCIe 5.0 공랭식 폼팩터.
-
워크로드 및 생태계: HPC(예: 금융 모델링, 탄성파 이미징), 분리형 및 에이전틱 AI 추론; 개방형 소프트웨어 스택을 통해 프로그래밍됨.
고성능 컴퓨팅(HPC)은 근본적인 변화를 겪고 있습니다. 전통적인 대규모 수치 모델링과 시뮬레이션이 여전히 기본 토대로 남아 있지만, 과학 및 기업 환경에서는 지속적인 워크플로 내에 시뮬레이션, 분석, AI 추론을 점점 더 통합하고 있습니다. 새롭게 부상하는 에이전틱 AI 아키텍처는 데이터, 모델, 도메인 도구를 자율 루프로 연결하여 입력을 준비하고, 중간 출력을 평가하며, 다음 시뮬레이션 단계를 동적으로 조작함으로써 이러한 발전을 가속화합니다.
이러한 수렴은 다양한 컴퓨팅 엔진이 워크플로의 정확한 단계를 실행하는 이기종 인프라를 요구합니다. 이전에 크레센트 아일랜드(Crescent Island)라는 코드명으로 알려졌던 인텔 GPU D270은 이러한 환경을 직접적으로 해결합니다. 고효율 AI 추론을 위해 처음부터 설계되었지만, 그 아키텍처는 까다로운 HPC 환경에서 요구되는 고정밀 수학 연산, 거대한 메모리 용량, 표준 기업용 폼팩터를 제공합니다.
까다로운 워크로드를 위한 네이티브 FP64 성능 및 대용량 메모리 과학, 엔지니어링 및 금융 시뮬레이션은 수치적 충실도를 유지하고 반올림 오차가 복합적으로 누적되는 것을 방지하기 위해 배정밀도 연산에 의존합니다. 인텔의 Xe 3P 아키텍처를 기반으로 구축된 인텔 GPU D270은 32개의 Xe 코어와 256개의 Xe Matrix Extensions(XMX) 엔진을 갖추고 있어 코어당 64회의 FP64 FMA(Fused Multiply-Add) 연산을 제공합니다. 이 아키텍처는 개발자에게 정밀도의 선택권을 제공합니다. 수학적 정확성이 타협 불가능한 곳에서는 풀 레이트의 네이티브 FP64 연산과 함께, 추론 처리량을 위한 더 낮은 정밀도(FP4~FP8)를 제공합니다.
메모리 아키텍처 역시 복잡한 작업 세트를 처리하는 데 똑같이 중요합니다. 인텔 브랜드 카드는 1.5 TB/s의 대역폭을 제공하는 160 GB의 고속 LPDDR5X 메모리를 탑재하고 있으며, 파트너가 설계한 구성은 최대 480 GB까지 확장할 수 있습니다. 이 상당한 메모리 용량을 통해 연구원들은 대규모 데이터셋과 파동장을 GPU 내에 상주시켜 호스트 버스를 통한 비용 소모가 큰 데이터 이동을 최소화할 수 있습니다. 이 모든 컴퓨팅 밀도는 표준 엔터프라이즈 서버에 배포하거나 랙 전체로 확장할 수 있는 표준 350와트 공랭식 PCIe 폼팩터에 들어맞습니다.
사전 생산 실리콘(pre-production silicon)을 기반으로 한 실제 애플리케이션 벤치마크는 금융 분석 및 과학 시뮬레이션 전반에서 D270의 균형 잡힌 아키텍처가 가진 실질적인 이점을 입증합니다.
금융 서비스: 옵션 가격 책정 벤치마크에서 D270은 NVIDIA RTX PRO 6000 Blackwell Server Edition에 비해 최대 5.9배 더 높은 애플리케이션 처리량¹을 제공하여 연산 집약적인 금융 모델링에서 탁월한 성능을 보여주었습니다. 이 성능은 NVIDIA GPU의 600W에 비해 D270이 350W에서 작동한다는 점을 감안할 때 특히 주목할 만합니다.
|
워크로드 |
애플리케이션 / 모델 |
기준 하드웨어 |
인텔 GPU D270 결과 |
|---|---|---|---|
|
금융 서비스 |
유럽형 몬테카를로 (European Monte Carlo) |
RTX PRO 6000 (Blackwell) |
5.9× 처리량¹ |
|
금융 서비스 |
블랙-숄즈 (유럽형) (Black-Scholes (European)) |
RTX PRO 6000 (Blackwell) |
5.6× 처리량¹ |
|
금융 서비스 |
이항 모델 (Binomial) |
RTX PRO 6000 (Blackwell) |
4.6× 처리량¹ |
|
금융 서비스 |
블랙-숄즈 (미국형) (Black-Scholes (American)) |
RTX PRO 6000 (Blackwell) |
1.92× 처리량¹ |
탄성파 탐사: 탄성파 모델링은 FP32 연산을 사용하여 대규모 3D 데이터셋 전체에서 반복적인 음향 파동 전파 계산을 요구하는 오일 및 가스 산업의 가장 까다로운 워크로드 중 하나입니다. 이번에는 D270의 FP32 연산과 결합된 높은 메모리 용량이 이 워크로드에 대해 강력한 성능을 보여줍니다. 캐시 인식 스텐실 최적화는 로컬 캐시 전반에서 데이터 재사용을 극대화하여 대규모 파동장 배열을 카드에 직접 상주시킵니다. 인텔은 당사 부스의 Supercomputing ‘26에서 라이브 데모를 통해 탄성파 모델링 기능을 시연하고 있습니다.
SC26에서 실행 중인 탄성파 분석 워크로드 시연 스틸컷.
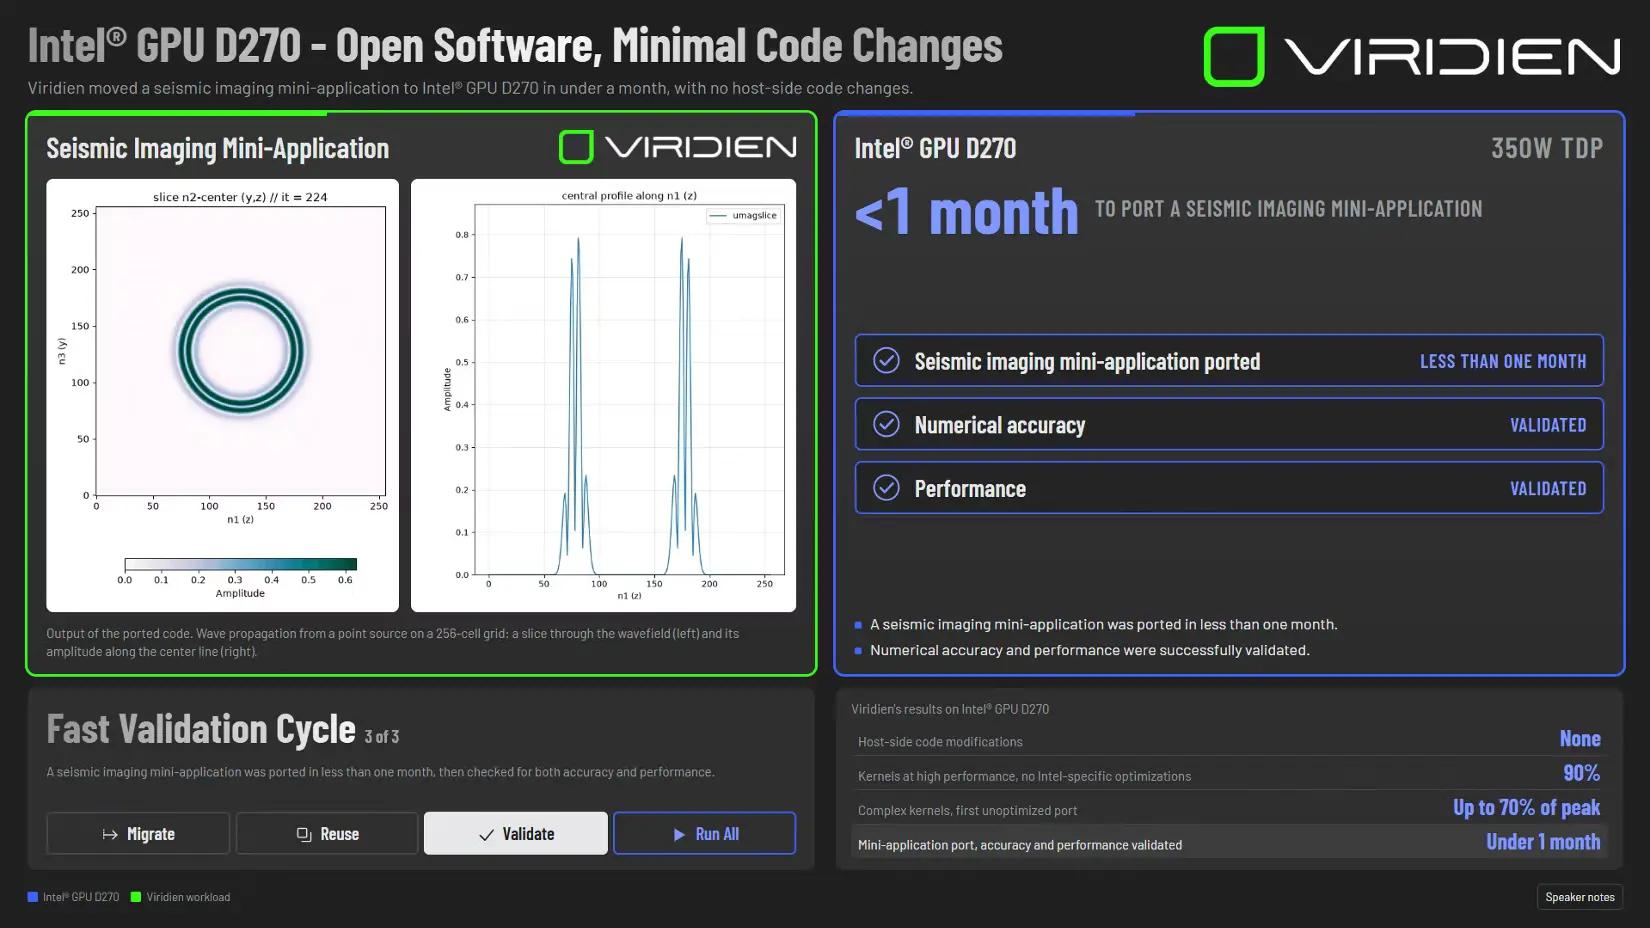
과학 컴퓨팅에 대한 메시지는 간단합니다. 메모리 용량은 더 큰 문제를 해결하는 데 도움이 되고, 더 스마트한 재사용은 데이터 이동을 단순화하며, 최적화된 개방형 프로그래밍 모델은 연구원들이 필요로 하는 애플리케이션 처리량을 제공합니다.
분리형 추론 및 AI 기반 HPC 현대 과학적 발견에서 AI 추론은 더 이상 시뮬레이션이 끝난 후 실행되는 별도의 작업이 아닙니다. 대신 시뮬레이션 루프 내부에서 직접 작동합니다. 사전 훈련된 AI 대리 모델은 물리 에뮬레이터 역할을 수행하여, 본격적인 수치 솔버를 시작하기 전에 유망한 후보군을 정확히 찾아내기 위해 수초 만에 수십만 개의 설계 매개변수를 스크리닝합니다. 이와 동시에 에이전틱 의사결정 모델은 시뮬레이션 원격 측정(telemetry)을 실시간으로 모니터링하여 불안정성을 식별하고, 메시 경계를 동적으로 세분화하며, 수동적인 인간의 개입을 기다리지 않고 자율적으로 다음 계산을 제어합니다.
그러나 고처리량 추론을 슈퍼컴퓨팅 루프에 통합하려면 속도와 극도의 운영 효율성이 요구됩니다. 모놀리식 컴퓨팅 노드는 서로 다른 연산 단계가 동일한 프로세서를 차지하기 위해 경쟁하도록 만들어 처리량을 저하시키고 지연 시간을 늘립니다.
분리(Disaggregation)는 추론 워크로드를 구성 연산 단계에 맞게 조정된 프로세서 전반에 분할함으로써 이 병목 현상을 해결하여, 에너지 및 리소스 활용도를 최적화하는 동시에 전반적인 실행 속도를 획기적으로 향상시킵니다. 이 분리형 청사진에서 인텔 GPU D270은 고차원 시뮬레이션 데이터셋, 대규모 프롬프트 및 과학적 컨텍스트 윈도우를 신속하게 처리하여 연산 집약적인 프리필(prefill) 단계를 구동합니다. SambaNova SN50 Reconfigurable Dataflow Units(RDU)는 메모리 제한적인 디코드(decode) 단계를 가속화하여 빠른 추론을 제공하며, 인텔 Xeon 6 및 Xeon 6+ 프로세서는 엔드투엔드 워크플로 오케스트레이션, 호스트 통신 및 도구 실행을 관장합니다. 인텔 GPU D-시리즈와 SambaNova RDU 전반에 걸쳐 워크로드를 오케스트레이션함으로써, 이 이기종 접근 방식은 전체 에이전틱 루프의 속도를 높여 값비싼 수치 연산을 유휴 상태로 두지 않고 자율 의사결정 모델이 시뮬레이션을 실시간으로 안내할 수 있도록 합니다. 동시에 이 모든 것은 공랭식 랙의 기존 전력 한계 내에서 안전하게 달성됩니다. 인텔과 SambaNova는 공급업체가 새로운 설비를 기다릴 필요 없이 가장 널리 쓰이는 소프트웨어 스택을 활용하여 AI 토큰 수요를 충족하도록 공급을 늘리는 데 도움을 주기 위해 이 솔루션을 구축하고 있습니다.
¹결과는 명시된 FP64 금융 서비스 워크로드를 기반으로 합니다.
인텔 GPU D270(SYCL* 구현)과 NVIDIA RTX PRO 6000 Blackwell Server Edition(최적화된 NVIDIA* CUDA*/SYCL 구현 활용) 간의 주요 HPC 워크로드(금융) 성능 비교입니다.
자세한 내용은 부록을 참조하십시오. 결과는 달라질 수 있습니다.
²Drex v2.0 성능은 Jev Decision Index latency-v1 750개 행(rows), 동시성(concurrency) 1 설정을 사용하여 측정되었습니다. 웜업(Warm-up): 64토큰 단위로 증가하는 64~2,560 토큰 상태 길이의 80개 요청 형상(shapes) × 1회 및 16개 질문을 시간 측정 전 각각 3회씩 전송(총 240개 요청)하여, 시간 측정 실행 전에 GPU 그래프가 캡처되도록 했습니다. 자세한 내용은 부록을 참조하십시오. 결과는 달라질 수 있습니다.
³Qwen 3 -30B-A3B-FP8 출력 토큰 처리량 비교: 인텔 GPU D270 대 NVIDIA RTX PRO 6000 Blackwell Server Edition (ISL/OSL=1k/1k, FP8, VLLM, 동시성 1~32). 자세한 내용은 부록을 참조하십시오. 결과는 달라질 수 있습니다.
부록 (Appendix)
1. 금융 서비스 구성 (Financial Services Configurations)
시스템 요약 (인텔): 1노드, 1x Intel(R) Xeon(R) 6741P, 48코어, 300W TDP, HT On, Turbo On, 총 메모리 768GB (8x96GB DDR5 6400MT/s [6400MT/s]), BIOS 1.6, 마이크로코드 0xa000151, 2x Ethernet Controller X550, 1x 3.5T SAMSUNG MZTL63T8HFLT-00AW7, Ubuntu Resolute Raccoon (개발 브랜치), 7.0.0-38-generic. GPU: 1x 인텔 GPU D270 (사전 생산 실리콘), 160 GiB. KMD: xeb_v7.1.4.58_260728.46, UMD: 1.18.40581, Level Zero: 1.34.0 GPU 소프트웨어 스택: oneAPI 2026.2 2026년 11월 6일 기준 인텔 자체 테스트.
시스템 요약 (NVIDIA): 1노드, 2x Intel(R) Xeon(R) 6944P, 72코어, 350W TDP, HT On, Turbo On, 총 메모리 2304GB (24x96GB DDR5 6400MT/s [6400MT/s]), BIOS 1.5, 마이크로코드 0x1000405, 2x Ethernet Controller X710 for 10GBASE-T, 2x MT2892 Family [ConnectX-6 Dx], 1x 3.6T INTEL SSDPE2KX040T8, 1x 1.7T MTFDKCC1T9TGP-1BK1DABYY, 1x 447.1G Micron_7450_MTFDKBA480TFR, Ubuntu 26.04.1 LTS, 7.0.0-42-generic. GPU: 8x NVIDIA RTX PRO 6000 Blackwell Server Edition (테스트에는 1개 카드만 사용), 96 GiB. 드라이버 595.91.07 GPU 소프트웨어 스택: nvidia/cuda:12.8.0-devel-ubuntu22.04 컨테이너, oneMath, DPC++ 7.2.0 2026년 11월 6일 기준 인텔 자체 테스트.
2. DREX 구성 (DREX Configurations)
인텔 (D270): Jev latency-v1, 런 A (80-형상 웜업) 시스템 요약: 1노드, 1x Intel(R) Xeon(R) 6741P, 48코어, 300W TDP, HT On, Turbo On, 총 메모리 1152GB (12x96GB DDR5 6400MT/s [5200MT/s]), BIOS 1.6, 마이크로코드 0xa000151, 2x Ethernet Controller X550, 1x 3.5T SAMSUNG MZTL63T8HFLT-00AW7, Ubuntu Resolute Raccoon (개발 브랜치), 7.0.0-38-generic. GPU: 1x 인텔 GPU D270 (사전 생산 실리콘), 160GiB (테스트에 단일 카드 사용, 2,500 MHz, 350W 전력 제한). KMD: xeb_v7.1.4.63_260728.50, UMD: 1.18.40430, Level Zero: 1.34.0 GPU 소프트웨어 스택: oneAPI 2026.3 (DPC++ 2026.3.0), 컨테이너 sglang-cri-drex:upstream-20261020-r28 (PyTorch 2.15.0a0 XPU, SGLang 0.5.23.dev412). 워크로드: nace-ai/drex-v2.0 (FP8 W8A8), 1개 카드에서 TP1, Jev Decision Index latency-v1 (750개 행, 동시성 1), 80-형상 그래프 웜업 후 5회 측정의 중앙값. 시간이 측정된 750개 행 - 총 1,712개 질문. 652개 행은 1개의 질문을 포함하며, 16개 행은 16개 이상의 질문을 포함하여 전체 상태를 유지한 채 16개 질문 단위로 순차 전송되어 한 번에 1개 행씩 측정됨. 2026년 11월 8일 기준 인텔 자체 테스트.
NVIDIA RTX PRO 6000: Jev latency-v1, 런 A (80-형상 웜업) 시스템 요약: 1노드, Amazon EC2 g7e.24xlarge (VM), 1x Intel(R) Xeon(R) Platinum 8559C, 48코어 (96 vCPU), HT On, 총 메모리 999GB (VM), AWS ENA, 200GB EBS + 2x 3.5T 인스턴스 NVMe, Ubuntu 24.04.5 LTS, 7.0.0-1014-aws. GPU: 1x NVIDIA RTX PRO 6000 Blackwell Server Edition, 96 GiB (테스트에 단일 카드 사용, 순정 부스트, 600W 제한). 드라이버 595.112.07 GPU 소프트웨어 스택: drex-sglang:local 컨테이너 (CUDA 13.0, PyTorch 2.13.0+cu130, SGLang 0.5.21, Triton 어텐션). 워크로드: nace-ai/drex-v2.0 (FP8 W8A8), 1개 카드에서 TP1, Jev Decision Index latency-v1 (750개 행, 동시성 1), 80-형상 그래프 웜업 후 5회 측정의 중앙값. 시간이 측정된 750개 행 - 총 1,712개 질문. 652개 행은 1개의 질문을 포함하며, 16개 행은 16개 이상의 질문을 포함하여 전체 상태를 유지한 채 16개 질문 단위로 순차 전송되어 한 번에 1개 행씩 측정됨. 2026년 11월 9일 기준 인텔 자체 테스트.
3. QWEN 구성 (QWEN Configurations)
인텔 (D270): Qwen3-30B-A3B FP8 시스템 요약: 1노드, 1x Intel(R) Xeon(R) 6741P, 48코어, 300W TDP, HT On, Turbo On, 총 메모리 1152GB (12x96GB DDR5, 5200 MT/s), BIOS AMI 1.6 (2026년 7월 23일), 마이크로코드 0xa000151, 2x Intel X550 Ethernet, 1x 3.5T Samsung NVMe, Ubuntu Resolute Raccoon (개발 브랜치), 7.0.0-38-generic. GPU: 1x 인텔 GPU D270 (사전 생산 실리콘) [8086:674c], 160GiB LPDDR5X (163,828 MiB; 테스트에 단일 카드 사용, PCIe Gen5 x16, 최대 2,500 MHz, 350W 전력 제한). KMD: xeb_v7.1.4.63_260728.50, UMD (Level Zero 드라이버): 1.18.40863, IFWI: 208.0.0.1050 GPU 소프트웨어 스택: 컨테이너 pytorch-ipex-spr:CRI_main_2850_ww45.5 (PyTorch 2.16.0a0 XPU, vLLM 0.1.dev1+gf8d7ca1e2 vllm-xpu). XPU 그래프 FULL_AND_PIECEWISE, torch.compile 비활성화(off), Flash Attention, FP8 KV 캐시. AIPerf 0.13.0. 워크로드: Qwen/Qwen3-30B-A3B-FP8 (FP8 W8A8, 128x128 블록), 1개 카드에서 TP1.
-
형상(Shapes): ISL/OSL 1024/1024, 동시성 1/8/16/32.
-
서빙(Serving): 16,384개 배치 토큰, 1,024개 최대 시퀀스, 프리픽스 캐싱 비활성화(off), 비동기 스케줄링.
-
클라이언트: ignore_eos가 적용된 챗 스트리밍. 각 셀은 최대(20, 4×C)개의 요청과 C개의 웜업 요청을 포함하며, 결과는 3회 실행의 중앙값임. 2026년 11월 7일 기준 인텔 자체 테스트.
NVIDIA RTX PRO 6000: Qwen3-30B-A3B FP8 시스템 요약: 1노드, Amazon EC2 g7e.24xlarge (VM), 1x Intel(R) Xeon(R) Platinum 8559C, 48코어 (96 vCPU), HT On, 터보 사용 불가(VM), 총 메모리 1TB (1x1TB DDR5 5600, VM), BIOS Amazon EC2 1.0, 마이크로코드 0x210002f4, 1x Amazon ENA, 200GB EBS + 2x 3.5T 인스턴스 NVMe, Ubuntu 24.04.5 LTS, 7.0.0-1014-aws. GPU: 1x NVIDIA RTX PRO 6000 Blackwell Server Edition, 96GiB GDDR7 ECC (97,887 MiB; 테스트에 단일 카드 사용, PCIe Gen5 x16, 최대 2,430 MHz SM, 600W 제한). 드라이버 595.112.07, CUDA 13.2 (드라이버), VBIOS 98.02.AF.00.01 GPU 소프트웨어 스택: vllm/vllm-openai:v0.33.0 컨테이너 (CUDA 13.0, PyTorch 2.14.0+cu130, vLLM 0.33.0). torch.compile + CUDA 그래프 FULL_AND_PIECEWISE, FlashInfer 어텐션, FP8 KV 캐시. AIPerf 0.13.0. 워크로드: Qwen/Qwen3-30B-A3B-FP8 (FP8 W8A8, 128x128 블록), 1개 카드에서 TP1.
-
형상(Shapes): ISL/OSL 1024/1024, 동시성 1/8/16/32
-
서빙(Serving): 16,384개 배치 토큰, 1,024개 최대 시퀀스, 프리픽스 캐싱 비활성화(off), 비동기 스케줄링.
-
클라이언트: ignore_eos가 적용된 챗 스트리밍. 각 셀은 최대(20, 4×C)개의 요청과 C개의 웜업 요청을 포함하며, 결과는 3회 실행의 중앙값임. 2026년 11월 7일 기준 인텔 자체 테스트.
--------------------------------------------------------------------------------------광고(Advertising)--------------------------------------------------------------------------------------------------------


