**번역본뉴스입니다. 오역이 있을수 있습니다.
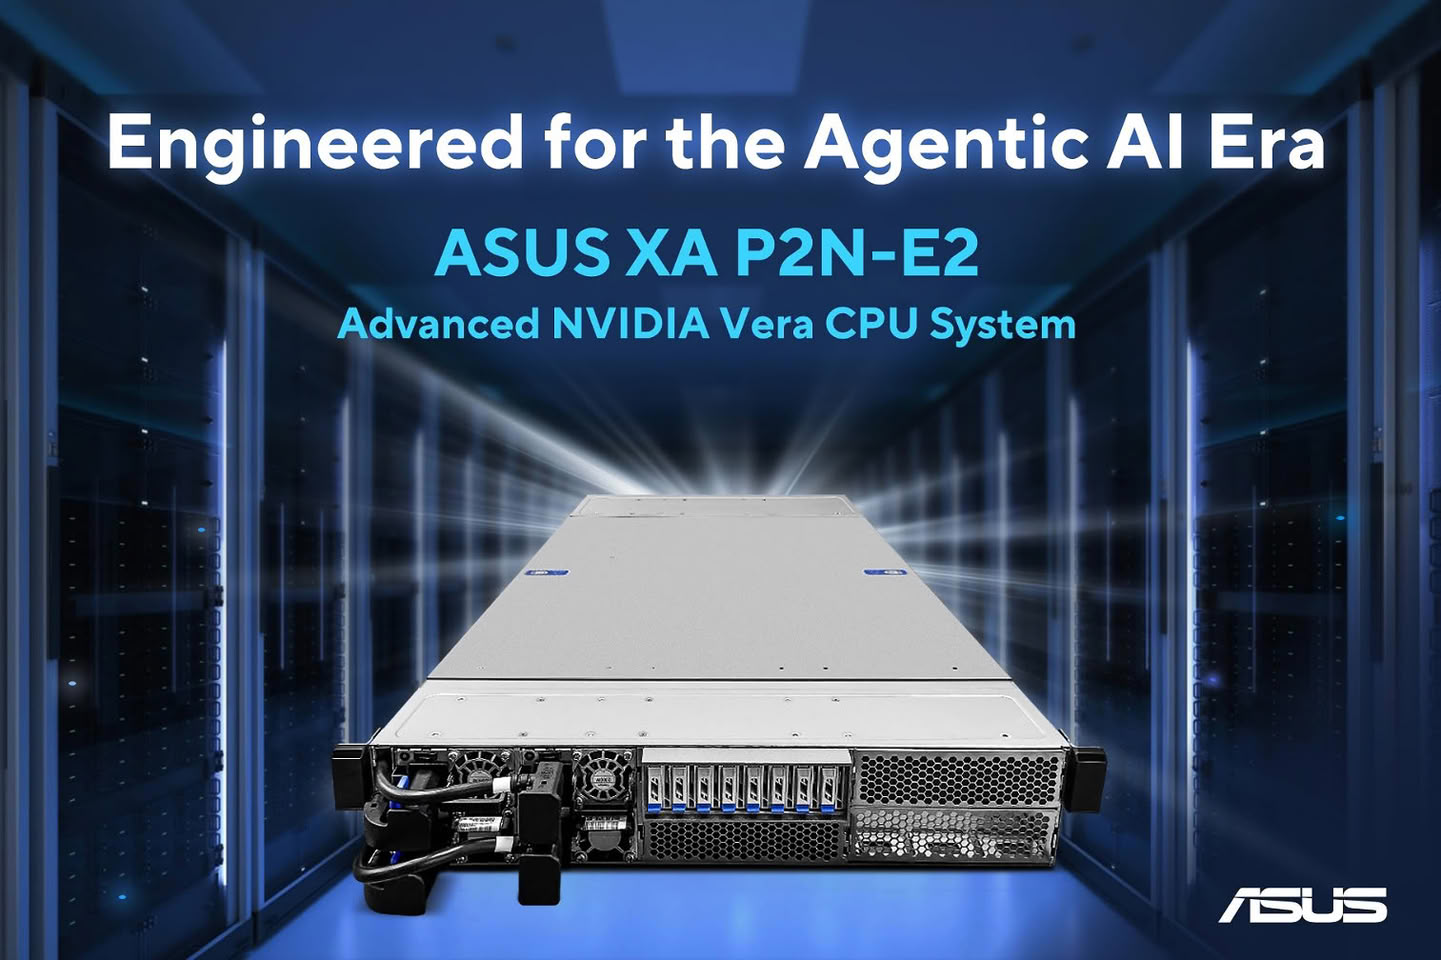
ASUS가 NVIDIA Vera CPU로 구동되며 에이전틱 AI(Agentic AI) 및 강화 학습 워크로드를 위해 설계된 2U NVIDIA MGX 아키텍처 기반 서버인 'XA P2N-E2'를 출시하며 자사의 AI 인프라 포트폴리오를 확장하고 있습니다. OCP 글로벌 서밋 2026(OCP Global Summit 2026)에서 공개된 이 새로운 Vera CPU 기반 ASUS 서버는 AI 애플리케이션의 실행 계층(execution layer)을 겨냥하여, AI 모델 자체를 넘어 코드 실행, 도구 사용, 샌드박싱, 데이터 처리 및 오케스트레이션과 같은 워크로드를 처리합니다. XA P2N-E2는 최대 2개의 듀얼 슬롯 NVIDIA RTX PRO 6000 블랙웰 서버 에디션(Blackwell Server Edition) GPU를 지원하여 콤팩트한 2U 플랫폼에서 고성능 CPU 컴퓨팅과 유연한 GPU 가속을 결합했습니다. 높은 싱글스레드 CPU 성능과 고대역폭·고효율 메모리는 까다로운 실행 및 평가 작업 중에도 AI 에이전트의 높은 반응성을 유지하도록 설계되었습니다.
ASUS는 OCP에서 랙 스케일 AI 시스템, 가속 컴퓨팅, 초고속 네트워킹, 컨텍스트 메모리, 저지연 추론 및 고밀도 스토리지를 아우르는 더 넓은 포트폴리오도 함께 선보입니다. 랙 레벨에서는 ASUS AI POD인 'XA VR721-E3'가 NVIDIA Vera Rubin NVL72 플랫폼을 통해 36개의 NVIDIA Vera CPU와 72개의 NVIDIA Rubin GPU를 통합하며, 대규모 AI 학습, 사후 학습(post-training) 및 추론을 위해 완전 수랭식 아키텍처를 사용합니다. 보다 유연한 서버 구성을 위해 'XR R1I12B-M1BHFS'는 NVIDIA HGX Rubin NVL8과 GPU 베이스보드용 다이렉트 투 칩(direct-to-chip) 액체 냉각, 그리고 인텔 제온 6 프로세서용 공랭 방식을 결합했습니다. 이들 시스템은 개별 서버부터 대규모 AI 환경에 이르기까지 다양한 연산 밀도, 냉각 아키텍처 및 배포 요구 사항에 걸쳐 AI 인프라를 확장하려는 ASUS의 접근 방식을 반영합니다.
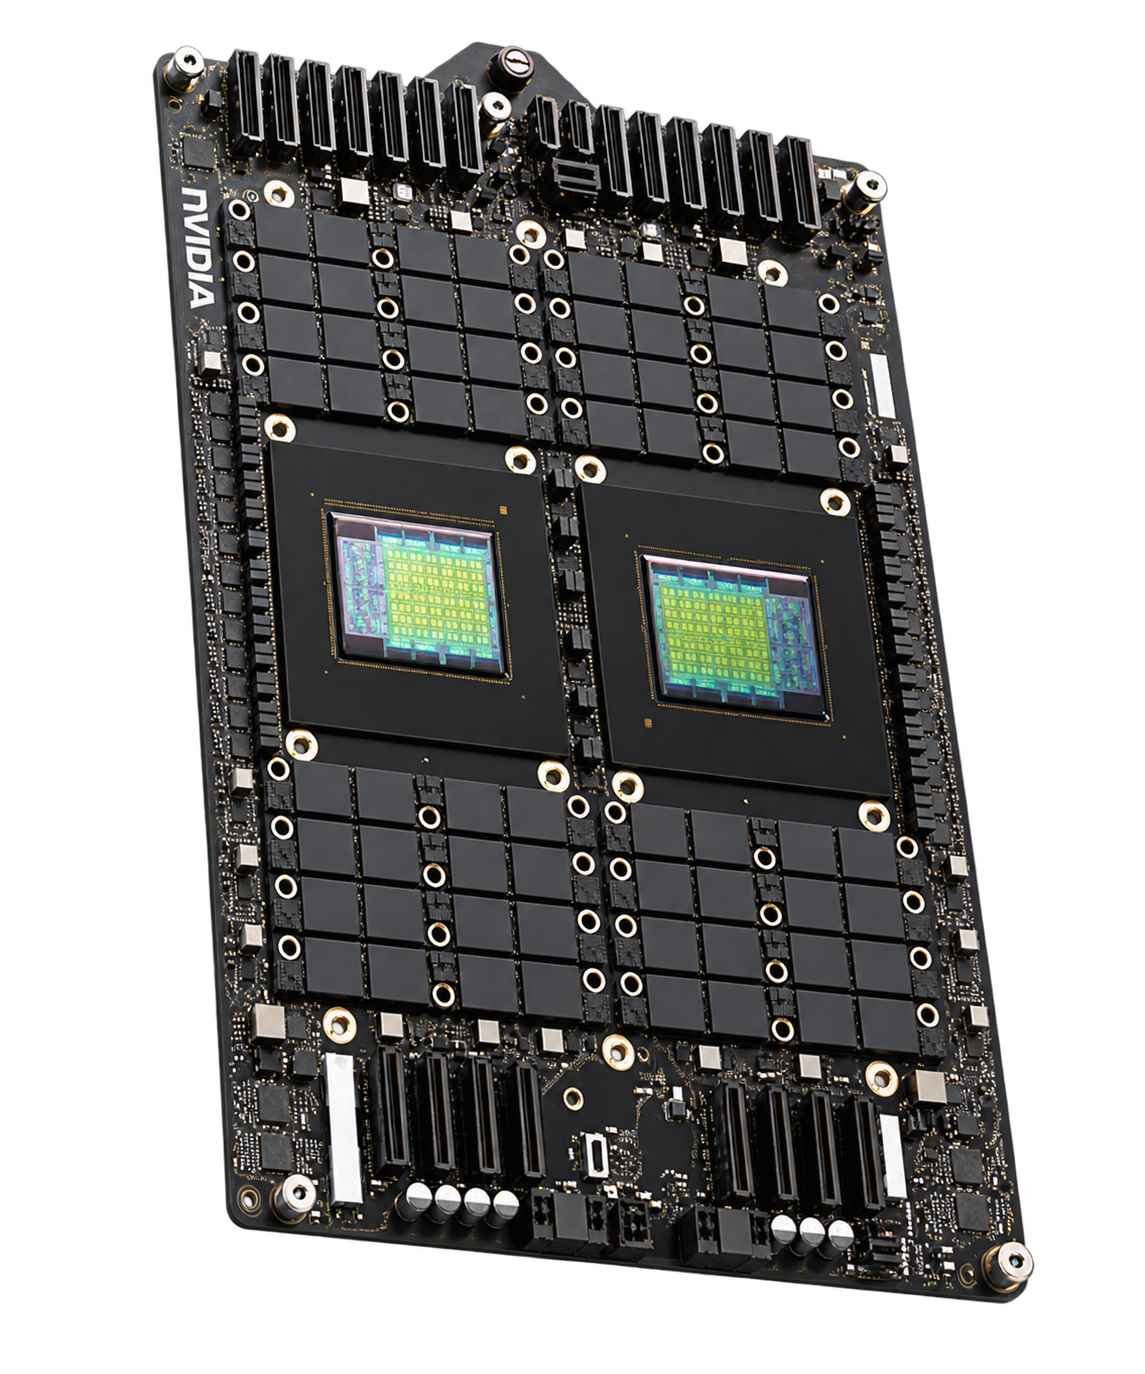
NVIDIA Vera Rubin 플랫폼을 통한 풀스택 AI 팩토리 구축 ASUS는 시스템 및 랙 아키텍처 전반에서 NVIDIA 가속 포트폴리오를 확장하여, 고객이 워크로드 요구 사항에 따라 연산 밀도, 냉각 및 배포 모델을 확장할 수 있도록 지원하고 있습니다. AI 팩토리의 성능은 점차 가속 컴퓨팅 하나만으로 결정되지 않습니다. 초고속 네트워킹, 확장 가능한 컨텍스트 메모리, 반응성이 뛰어난 추론 및 데이터 인프라는 점점 더 복잡해지는 AI 환경 전반에서 효율적인 데이터 이동과 워크로드 성능을 유지하는 데 모두 필수적입니다.
하드웨어 스택을 넘어, NVIDIA DSX Sim의 일환인 NVIDIA DSX 레퍼런스 디자인과 AI 팩토리 디지털 트윈을 위한 NVIDIA Omniverse DSX Blueprint는 검증된 아키텍처와 고충실도 시뮬레이션을 결합하여, 배포 전에 물리적으로 정확한 디지털 트윈을 통해 AI 팩토리 설계 및 운영을 최적화할 수 있도록 지원합니다.
ASUS 부스에 전시된 4가지 NVIDIA 기술은 차세대 AI 인프라의 핵심 요소를 하나로 모았습니다. 가속 컴퓨팅을 제공하는 NVIDIA HGX Rubin NVL8을 비롯해, 초고속 AI 네트워킹을 위한 NVIDIA Spectrum-X Spectrum-6 기반 이더넷 스위칭, 확장 가능한 컨텍스트 메모리를 위한 NVIDIA CMX 컨텍스트 메모리 스토리지 플랫폼, 그리고 NVIDIA Vera Rubin NVL72를 위한 인터랙티브 AI 추론 가속기인 NVIDIA Groq 3 LPX가 함께합니다.
에이전틱 시스템의 저지연 및 대규모 컨텍스트 요구 사항에 맞춰 설계된 NVIDIA Groq 3 LPX는 초고속 토큰 생성을 통해 매우 뛰어난 반응성의 추론을 지원하며 NVIDIA Vera Rubin NVL72를 확장합니다. 종합적으로 이들 시스템은 연산, 네트워킹, 컨텍스트 메모리, 추론 및 스토리지 전반에 걸쳐 표준화된 모듈형 인프라를 결합함으로써 NVIDIA Vera Rubin 플랫폼을 기반으로 확장 가능한 AI 팩토리를 구축하려는 ASUS의 접근 방식을 대변합니다. 이러한 풀스택 아키텍처를 통해 고객은 전력 대 성능비(와트당 성능)를 최적화하고 상용화 시간을 단축하면서 개별 시스템에서 랙 스케일 배포에 이르기까지 AI 인프라를 확장할 수 있습니다.
인텔 제온 6 프로세서 기반 에이전틱 AI 서버로 한계를 뛰어넘다 인텔 및 AMD 전용 쇼케이스 구역은 ASUS 플랫폼의 역량을 한층 더 강화하여, 고객이 클라우드 컴퓨팅, AI 및 고성능 컴퓨팅(HPC) 전반의 다양한 요구 사항에 맞춘 아키텍처를 선택할 수 있도록 돕습니다.
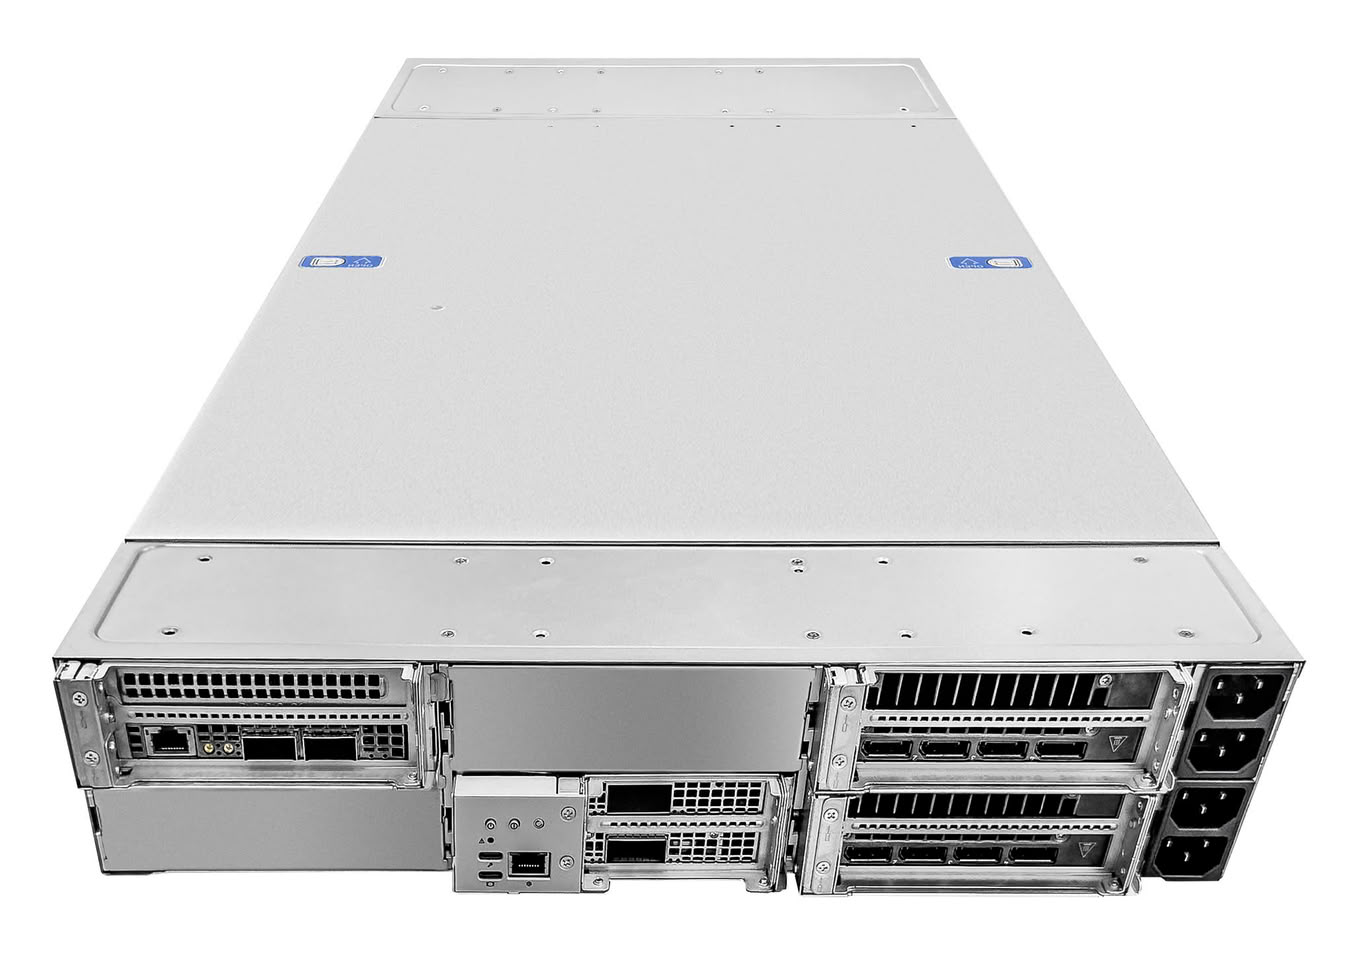
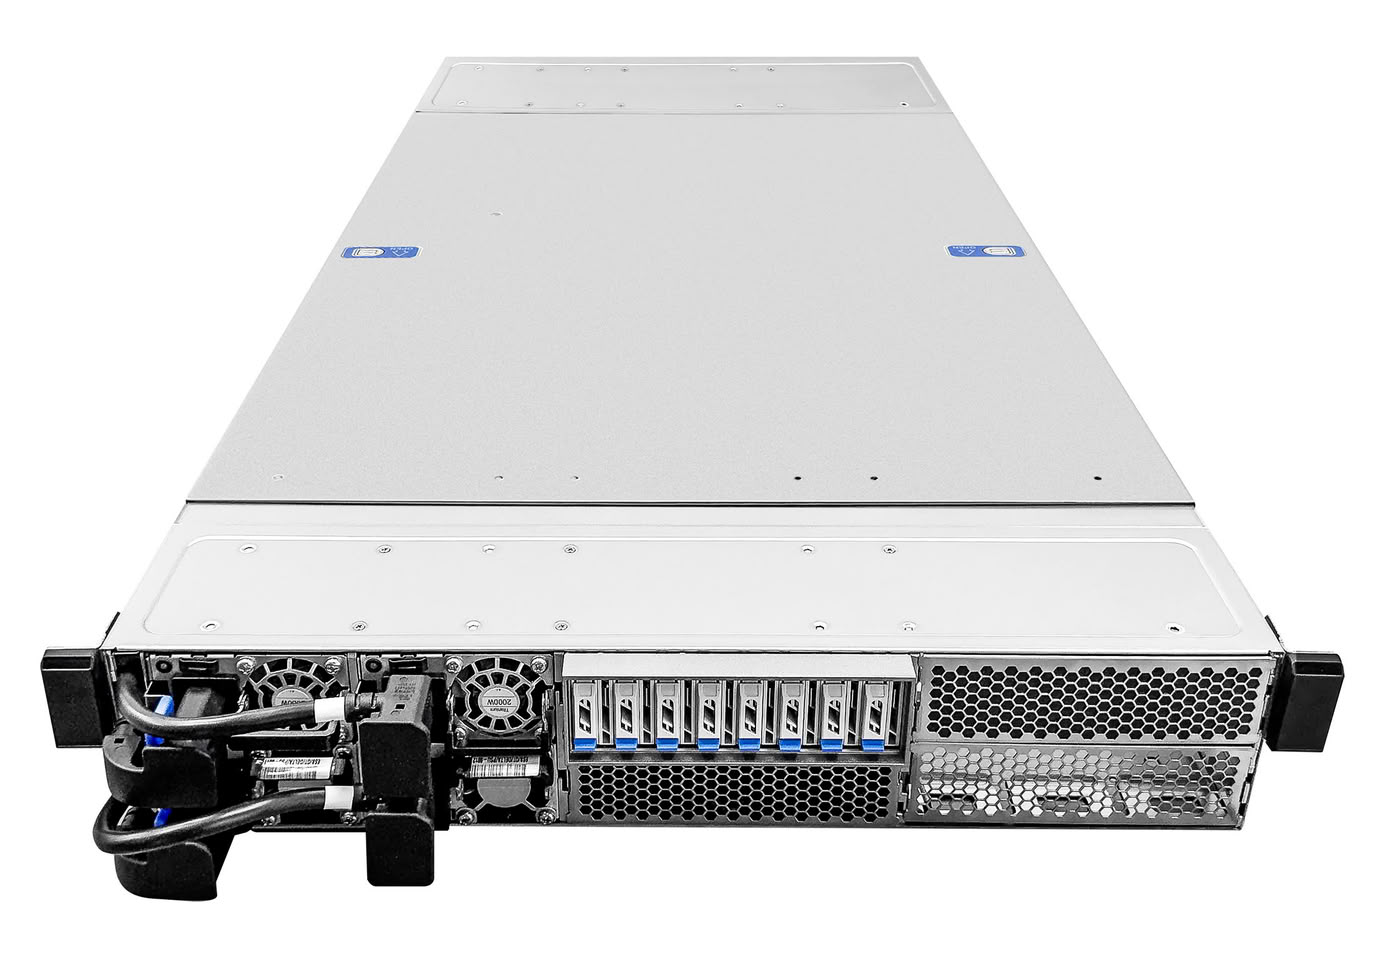
인텔 쇼케이스에서는 1U 및 2U 듀얼 소켓 플랫폼에서 인텔 제온 6 프로세서로 구동되는 ASUS RS700-E12-RS4U와 RS720-E12-RS12U를 선보입니다. 이들의 DC-MHS 설계와 무나사(tool-less) 서비스 편의성은 모듈식 배포와 간소화된 유지보수를 가능하게 하며, 에이전틱 AI, 가상화 및 데이터 집약적 워크로드를 위한 유연한 스토리지 및 확장 옵션을 제공합니다.
AMD EPYC 9006 및 Instinct 플랫폼을 통한 아키텍처 선택의 폭 확대 AMD 쇼케이스에서는 코드명 'Venice'인 6세대 AMD EPYC 9006 시리즈 프로세서로 구동되는 ASUS RS700A-E14B-R16U를 소개합니다. 엔터프라이즈급 복원력을 위해 설계된 이 1U 듀얼 소켓 플랫폼은 DC-MHS 아키텍처와 PCIe 6.0 연결성, 그리고 최대 16개의 E3.S 드라이브 지원을 결합하여 연산 및 데이터 집약적인 인프라 요구 사항을 해결합니다. 고밀도 설계를 보완하기 위해 ASUS Thermal Radar 3.0은 공랭 효율을 최적화하는 첨단 발열 모니터링 및 관리를 제공하여 까다로운 워크로드에서도 시스템 안정성과 성능을 유지하고 데이터 센터의 전반적인 열 관리를 개선하도록 지원합니다.
가속 AI 분야를 위해 ASUS ESC8000A-E13P는 AMD Instinct MI350P PCIe 가속기를 지원하며, XA AM3A-E13은 10U 설계에 8개의 AMD Instinct MI355X 가속기를 통합합니다. CPU와 GPU 부품 전반에 공랭 지원을 제공하는 XA AM3A-E13은 전용 냉수 인프라 없이도 고밀도 AI 배포를 가능하게 하여, 까다로운 AI 및 HPC 워크로드에 대한 확장성과 유지보수성을 유지하면서도 더 뛰어난 배포 유연성을 제공합니다.
OCP 글로벌 서밋 2026 전반에 걸쳐 ASUS는 시스템 및 랙 스케일 엔지니어링, 가속 컴퓨팅, 네트워킹 및 스토리지를 선도적인 기술 플랫폼과 결합하여 광범위한 AI, 클라우드 및 HPC 워크로드를 위한 유연한 인프라를 제공합니다. 이러한 통합 포트폴리오를 통해 조직은 진화하는 성능 및 확장성 요구 사항에 맞춰 연산 아키텍처, 데이터 인프라 및 배포 모델을 정렬할 수 있습니다.
방문객들은 OCP 글로벌 서밋 2026 기간 동안 ASUS 부스 #B9에서 ASUS의 전체 AI 인프라 포트폴리오를 직접 경험할 수 있습니다.
출시 및 가격 ASUS 서버는 전 세계에서 구매할 수 있습니다. 개별 제품 및 구성의 구매 가능 여부는 지역에 따라 다를 수 있습니다.
제품사이트 - https://servers.asus.com/products/servers/gpu-servers/XA-P2N-E2
--------------------------------------------------------------------------------------광고(Advertising)--------------------------------------------------------------------------------------------------------

 아스테라 랩스, 연산 장치에 구애받지 ...
 인텔 "Crescent Island" GP...


